Jahrelang haben sich Engineeringteams während Vorfällen mit derselben Herausforderung konfrontiert: Die Systeme, die Warnmeldungen generieren, werden immer komplexer, aber die anschließende Untersuchung erfolgt immer noch weitgehend manuell. Monitore sind gut darin, uns zu sagen, dass etwas nicht stimmt. Die schwierigere Frage ist warum.
Wenn eine Warnmeldung ausgelöst wird, muss ein Engineer immer noch herausfinden, wo er suchen soll, welche Signale wichtig sind, welche Hypothese zu testen ist und wie die Beweise über Logs und Metriken zusammenpassen. Die Arbeit ist notwendig, aber auch repetitiv, zeitaufwändig und stark davon abhängig, wer gerade Bereitschaftsdienst hat.
Der Root Cause Agent ändert diesen Ausgangspunkt, indem er einen agentischen Ansatz zur Vorfalluntersuchung bringt. Anstatt Engineers zu bitten, die Untersuchung selbst zusammenzustellen, sammelt der Agent relevante Telemetrie, bildet Hypothesen, folgt dem Signal über Logs und Metriken hinweg und liefert eine evidenzgestützte Bewertung der wahrscheinlichsten Ursache des Vorfalls.
Die Untersuchung ist der Engpass
Stellen Sie sich einen Checkout-Service mit steigender Latenz vor. Die Warnmeldung wird ausgelöst, der Engineer erhält den Alert, und die Untersuchung beginnt. Die Warnmeldung bietet einen wichtigen Ausgangspunkt, bestimmt aber nicht die Ursache. Der Engineer muss möglicherweise zwischen Dashboards und Suchanfragen wechseln, Signale über Services hinweg korrelieren, testen, ob ein Traffic-Anstieg, ein Abhängigkeitsproblem, ein Release oder eine Konfigurationsänderung verantwortlich ist, und entscheiden, welche Beweise aussagekräftig sind.
Dieser Prozess ist schwer zu standardisieren, da er stark von individueller Erfahrung abhängt. Ein erfahrener Engineer erkennt das Muster möglicherweise sofort. Jemand, der neu im Service ist, könnte viel länger brauchen, um herauszufinden, wo er anfangen soll, oder muss schließlich eskalieren. Und während eines Live-Vorfalls ist eine Antwort nur dann nützlich, wenn der Engineer sie verstehen und überprüfen kann.
Der Root Cause Agent ändert den Ausgangspunkt
Der Root Cause Agent ist dafür ausgelegt, diesen ersten Abschnitt der Untersuchung zu bewältigen. Wenn eine Warnmeldung einem konfigurierten Untersuchungs-Trigger des Teams entspricht, kann der Agent automatisch mit der Untersuchung beginnen. Er sammelt relevante Telemetrie, bildet Hypothesen, folgt dem Signal über Logs und Metriken hinweg und liefert ein strukturiertes Ergebnis. Teams können Untersuchungen auch bei Bedarf auslösen, und der Agent kann Warnmeldungen untersuchen, die außerhalb von Sumo Logic stammen.
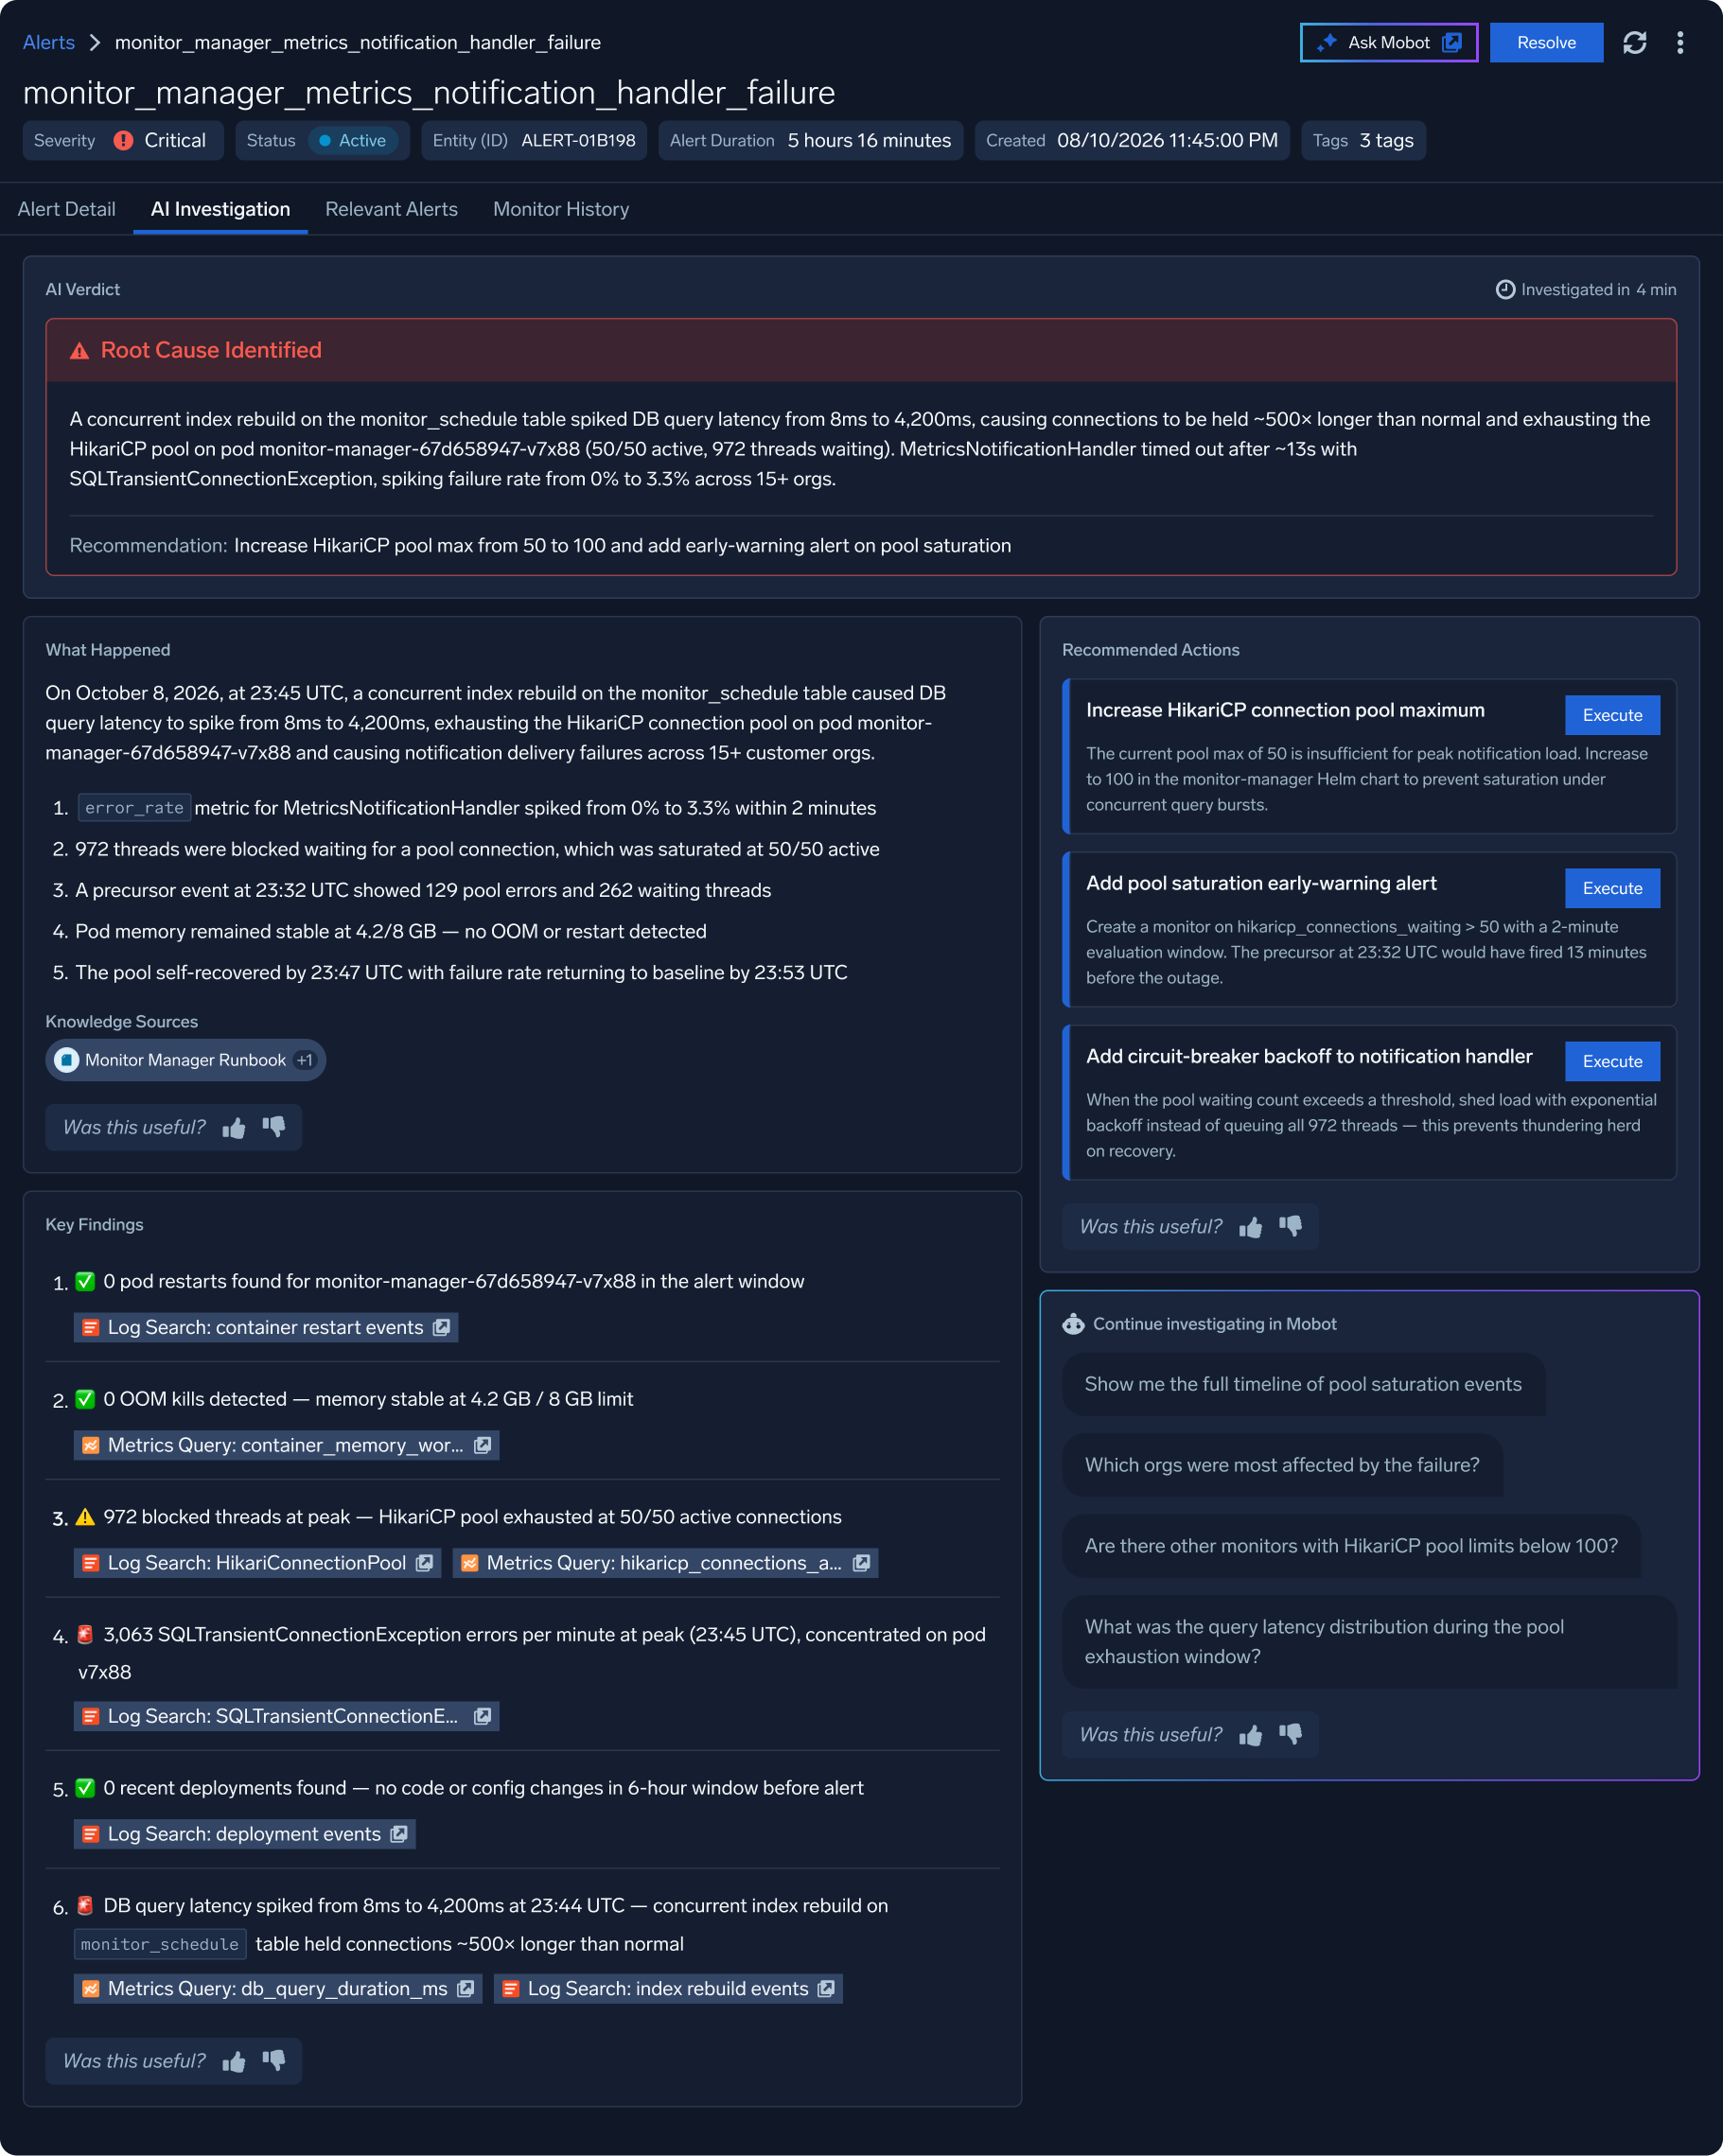
Das Ergebnis ist kein Textblock von KI-generiertem Inhalt. Es gibt dem Engineer ein klares Urteil, die Erkenntnisse, die dazu führten, die Beweise hinter diesen Erkenntnissen und einen empfohlenen nächsten Schritt. Jede Erkenntnis enthält die genaue Abfrage, die sie erzeugt hat, und ein Klick bringt den Engineer in die Suche mit dieser bereits ausgeführten Abfrage. Der Root Cause Agent bittet einen Engineer nicht, einer KI-Antwort zu vertrauen. Er gibt ihnen eine Untersuchung, die sie überprüfen und verifizieren können.
Von Sumo Logic-Telemetrie zum Kontext rund um den Vorfall
Die Untersuchung muss nicht bei der bereits in Sumo Logic vorhandenen Telemetrie enden. Der Root Cause Agent kann sich mit externen Kontext- und Telemetriequellen verbinden, sodass er die Systeme erreichen kann, die möglicherweise die entscheidenden Beweise enthalten: die Metrik, die angestiegen ist, die Bereitstellung, die sich geändert hat, das Feature Flag, das umgeschaltet wurde, oder der andere Kontext, der erklärt, was passiert ist. Er kann auch Warnmeldungen untersuchen, die außerhalb von Sumo Logic stammen.
Die Untersuchung kann auch in die Workflows übergehen, die Engineers bereits verwenden. Mit Slack können Teams eine Untersuchung anfordern und die Ergebnisse überprüfen, ohne zum Produkt zurückzukehren, während Mobot eine natürlichsprachliche Möglichkeit bietet, Folgefragen zu stellen und die Untersuchung fortzusetzen.
Wenn der Agent Teil des Betriebsablaufs einer Organisation wird, können Teams sein Wissen, benutzerdefinierte Anweisungen, verbundene Systeme und Untersuchungs-Trigger verwalten. Governance- und Berechtigungskontrollen bieten den Zugriff und die Scoping-Möglichkeiten, die für den Betrieb des Agenten in der gesamten Organisation erforderlich sind.
Entwickelt für Engineers zum Überprüfen, Entscheiden und Handeln
Der Wert liegt nicht einfach in schnellerem Zugriff auf mehr Telemetrie. Es geht um weniger manuelle Untersuchung und einen konsistenteren Ausgangspunkt für jeden Responder. Anstatt den Anfang eines Vorfalls damit zu verbringen, Daten zu sammeln und Signale zusammenzusetzen, können Engineers damit beginnen, die Bewertung und Beweise des Agenten zu überprüfen, die Abfragen hinter den Erkenntnissen zu überprüfen, die Schlussfolgerung bei Bedarf in Frage zu stellen, Folgefragen zu stellen und zu entscheiden, was als Nächstes zu tun ist.
Eine strukturierte Untersuchung gibt neueren Engineers einen stärkeren Ausgangspunkt, ohne dass sie bereits jede Ecke des Service kennen müssen, und reduziert die routinemäßige Datenerfassung und Korrelation, die erfahrene Engineers bei jedem Vorfall absorbieren müssen. Und da der Agent die Beweise hinter seinen Erkenntnissen zeigt und weiß, wann er keine verteidigbare Schlussfolgerung erreichen kann, können Engineers schnell vorgehen, ohne KI als Black Box zu behandeln. Das Ergebnis ist eine Verschiebung in der Verwendung von Engineering-Zeit: weniger Zeit damit verbracht, herauszufinden, wo man suchen soll, und mehr Zeit damit verbracht, das Problem zu verstehen, die Entscheidung zu treffen und den Vorfall zu beheben.
Überzeugen Sie sich selbst
Der Root Cause Agent ist heute in der Vorschau für Sumo Logic Log Analytics-Kunden verfügbar. Kontaktieren Sie Ihr Account-Team, um zu beginnen.
Diese Funktionen befinden sich in der Entwicklung. Verfügbarkeit, Zeitpunkt und Funktionalität können sich ändern, und die Elemente sollten bis zur allgemeinen Verfügbarkeit als richtungsweisend behandelt werden.